
Une IA qui tourne sur votre ordinateur, sans compte, sans abonnement, sans envoyer un mot à un serveur à l’autre bout du monde : c’est déjà possible, gratuitement et en 20 minutes. Un exemple : Ollama.
En bref
- Ollama installe une IA sur votre PC ou votre Mac comme n’importe quel logiciel ; les modèles gratuits se téléchargent en un clic, de 2 à 20 Go.
- Vos questions ne quittent pas votre machine, et l’énergie consommée est celle de votre ordinateur, pas celle d’un data center refroidi à l’eau.
- Attendez-vous à un assistant appliqué et un peu lent, loin derrière ChatGPT ou Claude ; pour coder, OpenCode s’y branche et fait le travail de base.
Pourquoi se donner cette peine
À la fin de mon article sur Hacker la Tech, j’écrivais que cette journée changeait la façon dont je tiens l’outil. L’IA locale est le geste le plus concret qui en découle. Alain Damasio parlait de « mini-IA » et de « serveurs locaux » ; Herman Salazar racontait l’eau pompée sous sa commune pour refroidir les serveurs de Google. Une IA qui tourne chez vous règle trois problèmes d’un coup.
Ce que vous lui dites ne quitte pas votre machine.
Elle ne consomme que l’électricité de votre ordinateur.
Elle continue de marcher le jour où l’entreprise change ses prix, ses règles ou ses idées.
Ce qu’il vous faut
Un ordinateur récent suffit pour commencer. Ce qui compte, c’est la mémoire, parce qu’elle décide de la taille du modèle qui tient chez vous.
Tourne sur à peu près n’importe quelle machine de moins de cinq ans.
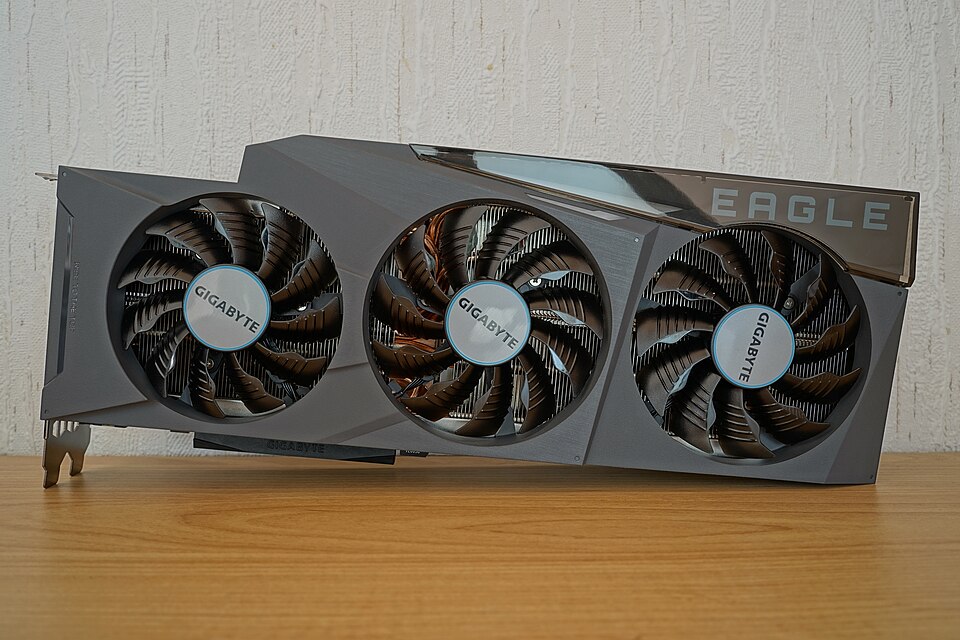
Demande beaucoup de RAM ou une carte graphique avec 8 Go de mémoire ou plus.
Pour situer : mon ordinateur portable a une carte graphique de 8 Go et 64 Go de mémoire vive, ce qui me permet un petit modèle très rapide et un modèle moyen plus lent mais plus malin.
Pas à pas : votre première conversation
- Téléchargez Ollama sur ollama.com et installez-le comme n’importe quel logiciel (Windows, Mac ou Linux). C’est un projet libre, gratuit.
- Ouvrez l’application. Depuis 2025, Ollama a une vraie fenêtre de discussion ; plus besoin de ligne de commande pour débuter.
- Choisissez un modèle dans la liste déroulante. Prenez-en un marqué d’une icône de téléchargement (il tournera chez vous) et évitez ceux marqués d’un nuage (ils tournent chez Ollama, ce qui est précisément ce qu’on veut éviter). Pour un premier essai, un modèle de 4 à 9 milliards de paramètres, en version compressée, est le bon compromis.
- Écrivez « bonjour ». Le modèle se télécharge (quelques minutes), se charge, et répond. À partir de là, tout se passe hors ligne : vous pouvez couper le wifi pour vérifier.
- Si vous préférez une autre interface, LM Studio fait la même chose avec plus de réglages visibles, et Open WebUI transforme Ollama en une page web qui ressemble à ChatGPT, dans votre navigateur, toujours chez vous.
Présente-toi en trois phrases, puis dis-moi ce que tu sais faire et ne sais pas faire sur mon ordinateur.
Une fois installé, on ne sait pas quoi demander. C’est normal. Une bonne demande contient trois choses : le contexte (de quoi il s’agit), la tâche (ce que vous voulez) et le format (en combien de lignes, sous quelle forme). Les messages de départ ci-dessous suivent tous ce schéma ; remplacez simplement ce qui est entre [crochets].
Huit usages concrets, chez vous
1. Dicter en vrac, affiner à deux
On dicte à son téléphone, en marchant ou en cuisinant, des idées dans le désordre, des phrases pas finies. Le texte brut passe ensuite dans le modèle local. Rien de ce qu’on dicte ne sort de la maison, c’est ça qui est important : préserver son intimité.
Voici une dictée en vrac. Garde mes mots et mon ton. Enlève les répétitions, regroupe les idées qui vont ensemble et propose un plan en 3 à 5 parties. N’ajoute aucune idée. Texte : [collez ici]
2. Relire avant d’envoyer
Une lettre de candidature, un courrier à un médecin, un contrat, un message difficile : le modèle local relit, corrige, propose une version plus adaptée, et le texte n’a jamais quitté votre disque.
Relis ce courrier. Corrige les fautes, signale les passages ambigus ou trop brusques, et propose une version plus adaptée en gardant mon vocabulaire. Courrier : [collez ici]
3. Traduire son propre travail
Un premier chantier tout désigné pour le modèle de code : traduire en anglais les textes de l’interface d’une application, un millier et demi de petites phrases. Tâche répétitive, bornée, vérifiable ; exactement ce qu’un modèle local fait bien.
Traduis en anglais le texte suivant. Garde le ton. Ne traduis pas les mots entre accolades {comme ceci}. Donne uniquement la traduction. Texte : [collez ici]
4. Construire un petit instrument
Un projet du dimanche que j’ai en tête : une appli qui suit les satellites et les étoiles au-dessus de Montpellier, avec un petit boîtier Arduino qui pointe le ciel. Le modèle de code local écrit les morceaux un par un ; on les assemble, on teste, on décide, sans compte ni abonnement.
Je veux écrire une petite application qui [décrivez en une phrase]. Propose d’abord un découpage en 5 étapes simples. Puis écris seulement la première étape, avec des commentaires, et explique-moi comment la tester.
5. Interroger ses propres notes
Des années de carnets, de fiches de lecture, de notes de réunion : un modèle local peut les lire et répondre « où ai-je noté ça ? ». Pour qui oublie vite, c’est une mémoire de secours qui ne regarde personne. Dans la fenêtre d’Ollama, on colle les notes dans la conversation ; Open WebUI permet d’y déposer des documents.
Voici mes notes. Réponds uniquement à partir d’elles. Où ai-je noté quelque chose sur [sujet] ? Cite le passage exact, et réponds « introuvable » si ce n’est pas dedans. Notes : [collez ici]
6. Se faciliter l’administratif
Une lettre de l’administration, une notice, un contrat de bail. Pour un proche qui lit mal le français, qui voit mal, ou qui décroche devant trois pages de jargon, un modèle local extrait les informations importantes et les synthétise, dans un langage compréhensible, sans envoyer ses papiers nulle part.
Explique-moi ce courrier comme à un ami, en dix lignes maximum. Dis-moi ce qu’on me demande, avant quelle date, et ce que je dois faire en premier. Courrier : [collez ici]
7. Une IA pour l’immeuble
Un vieil ordinateur dans un placard, Ollama dessus, accessible par le wifi de la cage d’escalier ou du local associatif : une IA partagée, sans compte, pour l’atelier de quartier, la maison de retraite, le tiers-lieu. C’est la « contre-culture des mini-IA » de Damasio au sens le plus littéral, et ça coûte le prix d’une multiprise.
Tu es l’assistant de [nom du lieu]. Tu réponds en français simple, en phrases courtes. Tu aides à écrire un courrier, remplir un formulaire ou comprendre un document. Si tu ne sais pas, tu le dis et tu proposes de demander à un humain du lieu.
8. Décrire ses images
Certains modèles locaux voient les images : ils écrivent les textes alternatifs des photos d’un site, trient un dossier de captures, décrivent un visuel à quelqu’un qui ne le voit pas. Utile pour un graphiste, et sans envoyer sa production à un serveur. Dans la bibliothèque d’Ollama, cherchez les modèles étiquetés « vision ».
Décris cette image en une phrase de 125 caractères maximum, pour un texte alternatif de site web. Puis décris-la en trois phrases pour une personne qui ne la voit pas.
Le point commun : des tâches bornées, où l’on reste aux commandes, et où la confidentialité ou la répétition pèsent plus que la finesse du résultat. Pour le reste, les grands modèles gardent l’avantage ; autant le savoir. Et si une réponse déçoit, demandez simplement : « refais en plus court » ou « explique plus simplement ».
Ce que ça vaut, honnêtement
Résumer un texte, reformuler un mail, traduire, expliquer une notion, écrire un brouillon.
Il est un peu plus lent que les services en ligne et se trompe plus souvent sur les faits précis : il n’a pas accès au web, et sa mémoire date de son entraînement.
Un modèle moyen fait mieux, au prix d’une attente plus longue. Pour mes usages (relire, structurer, traduire), c’est largement suffisant ; pour vérifier un chiffre ou écrire un article comme celui-ci, je continue d’utiliser un grand modèle, en le sachant, et en le disant.
Pour coder : OpenCode
Mes applications sont écrites avec l’aide d’un assistant de code. Depuis cet automne, je prépare son remplacement par OpenCode, un outil libre qui fait le même travail dans le terminal et qui accepte n’importe quel modèle, y compris ceux d’Ollama. Le réglage que j’ai retenu :
Une trentaine de milliards de paramètres ; il tient grâce à la mémoire vive.
7 milliards de paramètres, entièrement dans la carte graphique.
L’attente réaliste, notée dans mon plan avant de commencer : un junior appliqué et rapide, bon pour traduire des textes d’interface, corriger un bug ciblé, écrire des tests ; pas un chef de projet capable de piloter seul une grosse fonctionnalité. Et c’est précisément cette limite qui rend l’outil tenable, parce qu’elle oblige à rester aux commandes.
Lis le dossier de ce projet et explique-moi en dix lignes comment il est organisé. Ne modifie rien.
Dans le fichier [nom du fichier], corrige ce problème : [décrivez-le]. Montre-moi la modification avant de l’appliquer.
Pour installer OpenCode, la documentation officielle donne une ligne à coller dans le terminal, puis un fichier de réglages où l’on indique « fournisseur : Ollama » et le nom du modèle. Je publierai le détail de ma configuration quand le pilote sera terminé.
Et l’énergie ?
Un modèle local fait chauffer votre ordinateur comme un jeu vidéo pendant qu’il répond, puis se tait. Quelques dizaines de watts, le temps d’une réponse, et zéro litre d’eau. Un grand modèle en ligne mobilise une part d’un data center, son refroidissement et son réseau pour la même question.
Je n’ai pas de comparaison chiffrée fiable à vous proposer, et la différence dépend beaucoup du modèle et de la machine ; mais l’ordre de grandeur et, surtout, la localisation de l’impact changent : il est chez vous, visible, sur votre facture, au lieu d’être à Quilicura ou à Memphis.
Pour finir
Installer une IA chez soi est un geste modeste, et solide : il rappelle qu’une IA est un logiciel, qu’on peut l’avoir sur sa machine comme on a un traitement de texte, et qu’on n’est pas obligé de la louer à ceux qui construisent des bunkers. C’est le contre-animisme de Damasio en pratique : un programme sur un disque dur, qu’on ouvre et qu’on ferme. La même logique vaut pour les réseaux : Meshtastic pour parler à son quartier sans opérateur, et Signal, Matrix et le Fediverse pour parler au monde sans géant.
Pour continuer dans le Journal : Hacker la Tech : ce que l’IA fait au monde, en clair, et l’IA au quotidien, petits usages, vrai coût et esprit critique.
Cet article est écrit sur mon temps libre. Un grand merci à Noémie pour ses relectures et pour son soutien !
Si l’article vous a plu, vous pouvez nous offrir un café sur Ko-fi.
Restons en contact
Une lettre par mois : ce que je lis, ce que je vérifie, ce que je construis.
Image d'ouverture réalisée avec l'aide de l'IA (Gemini). Aucun lien commercial avec les logiciels cités.
Les 4 sources de cet articleSites officiels des projets et un guide d'installation
- Ollama, site officiel et bibliothèque de modèles. ollama.com
- OpenCode, site et documentation. opencode.ai
- LocalLLM, « How to Run a Local LLM on Windows in 2026 », mis à jour le 10 mai 2026 (application Ollama, modèles pour 8 Go, LM Studio, Open WebUI). localllm.in
- LM Studio et Open WebUI, sites officiels. lmstudio.ai ; openwebui.com
0 commentaires